1. Para que serve
O Bootstrap dos Coeficientes é uma ferramenta complementar da Regressão Linear do SisDEA, pensada para uma situação muito comum na avaliação de imóveis: poucos dados de mercado. Os resultados clássicos da regressão (erro padrão, estatística t, p-valor e intervalos de confiança dos coeficientes) dependem de suposições sobre os resíduos — em especial, de que eles sigam uma distribuição normal. Com muitos dados, essas suposições pesam pouco. Com 10, 15 ou 20 imóveis, porém, basta um resíduo mais afastado ou uma distribuição um pouco assimétrica para que os p-valores e os intervalos clássicos deixem de ser confiáveis.
O bootstrap responde à pergunta “quão estáveis são os coeficientes da minha equação?” sem depender da hipótese de normalidade: em vez de usar uma fórmula teórica, ele recria milhares de amostras semelhantes à original, recalcula a regressão em cada uma e observa como os coeficientes variam.
O bootstrap não altera o modelo nem a equação: ele apenas acrescenta uma segunda opinião sobre a precisão dos coeficientes já calculados.
2. Conceitos básicos
2.1 A ideia do bootstrap
Na regressão, o valor de cada imóvel é explicado por duas partes: o valor ajustado pela equação e o resíduo (a diferença entre o valor observado e o ajustado). O bootstrap do SisDEA parte dessa separação:
- Calcula a regressão original e guarda os valores ajustados e os resíduos;
- Cria uma amostra artificial: a cada imóvel soma-se ao seu valor ajustado um resíduo “sorteado” (ver seção 2.2);
- Recalcula a regressão nessa amostra artificial e anota os coeficientes obtidos;
- Repete os passos 2 e 3 milhares de vezes (as reamostras).
Ao final, cada coeficiente tem milhares de valores possíveis. A dispersão desses valores mostra a incerteza do coeficiente; os valores extremos definem o intervalo de confiança.
As características dos imóveis (área, padrão, localização, etc.) não são sorteadas: elas ficam fixas em todas as reamostras, e só a parte aleatória (o resíduo) varia. Isso tem uma vantagem importante em amostras pequenas — nenhuma reamostra pode “perder” uma característica. Por exemplo, se apenas dois imóveis da amostra têm piscina, sortear imóveis inteiros poderia gerar amostras sem nenhum imóvel com piscina, e a regressão não poderia ser calculada. Com as características fixas, isso nunca acontece.
Antes do sorteio, os resíduos são corrigidos pela alavancagem: imóveis muito diferentes dos demais (alta alavancagem) “puxam” a equação para perto de si e por isso têm resíduos artificialmente pequenos. A correção devolve a esses resíduos o tamanho que teriam, e o sorteio não subestima a incerteza.
2.2 Os dois métodos
| Método | Como o resíduo é sorteado | Suposição | Quando usar |
| Resíduos (homocedasticidade) | Para cada imóvel sorteia-se, com reposição, qualquer um dos resíduos da amostra | A variação dos resíduos é parecida em toda a amostra (homocedasticidade) | Uso geral, quando os testes e gráficos de resíduos não indicam heterocedasticidade |
| Wild (heterocedasticidade) | Cada imóvel mantém o seu próprio resíduo, que tem o sinal trocado ao acaso (+ ou −) | Nenhuma sobre a variação dos resíduos | Quando há sinais de heterocedasticidade — por exemplo, imóveis maiores ou mais caros com resíduos maiores |
Na dúvida, calcule pelos dois métodos. Se os resultados forem parecidos, a conclusão é robusta. Se forem muito diferentes, os resíduos provavelmente não têm variação constante, e o método Wild é o mais adequado.
2.3 Por que apenas amostras pequenas
O bootstrap no SisDEA é restrito a amostras com até 100 dados. Acima desse tamanho, os resultados clássicos da regressão já são razoavelmente robustos a desvios de normalidade, e o bootstrap acrescenta pouca informação. O limite existe para deixar claro o papel da ferramenta: um complemento para amostras pequenas, e não um substituto da inferência clássica.
3. Antes de começar
O bootstrap fica em Regressão Linear → Ferramentas → Calcular → Bootstrap – Coeficientes e trabalha sobre a regressão linear já calculada:
- O modelo precisa estar calculado. Enquanto não estiver, a opção fica desabilitada.
- O modelo deve ter no máximo 100 dados considerados (dados habilitados). Se tiver mais, o SisDEA exibe um aviso e a tela do bootstrap não é aberta (ver seção 8).
- São usadas as transformações da equação selecionada (por exemplo,
ln(y),1/x,x²), exatamente como aparecem nos resultados da regressão. Para analisar outra equação, selecione-a primeiro e abra o bootstrap de novo. - Entram no cálculo apenas as variáveis numéricas habilitadas e os dados habilitados.
- O número de dados precisa ser maior que o número de coeficientes da equação (variáveis independentes mais o intercepto).
4. Os campos da tela
| Campo | O que significa | Padrão |
| Método | Resíduos (homocedasticidade) ou Wild (heterocedasticidade) — ver seção 2.2. | Resíduos |
| Reamostras | Quantas amostras artificiais são geradas: 999, 1999 ou 9999. Mais reamostras deixam os limites dos intervalos mais estáveis. Com até 100 dados o cálculo é praticamente instantâneo, então não há motivo para usar menos que 9999 no resultado final. | 9999 |
| Calcular | Refaz o cálculo com o método e o número de reamostras escolhidos. | — |
| Copiar | Copia a tabela de resultados, com o cabeçalho e a nota explicativa, para a área de transferência. O texto é separado por tabulações e pode ser colado diretamente no Excel ou no Word. | — |
O cálculo é feito automaticamente ao abrir a tela, com os valores padrão. O sorteio usa sempre a mesma sequência inicial. Por isso, os mesmos dados, com o mesmo método e o mesmo número de reamostras, produzem sempre os mesmos resultados — o que permite reproduzir e conferir os números citados em um laudo.
Como interpretar os resultados
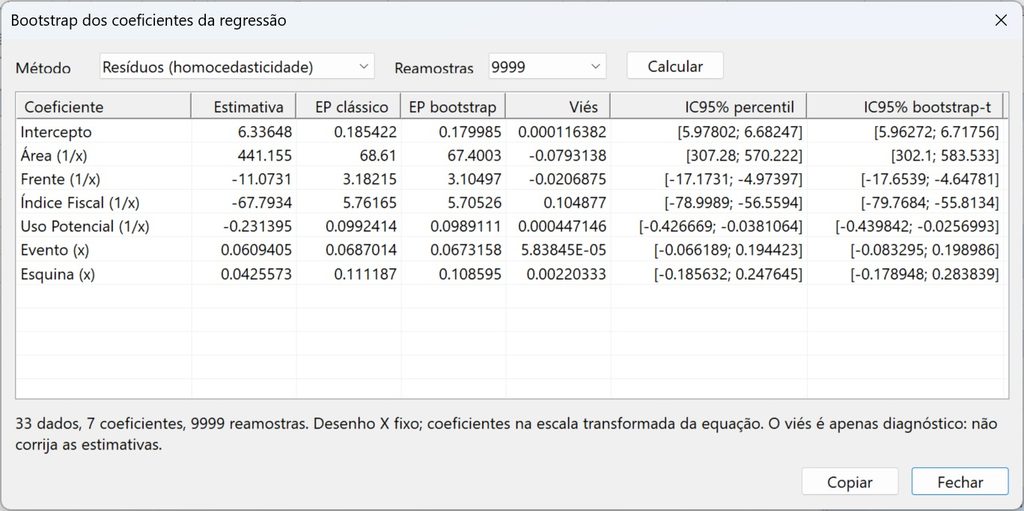
A tabela tem uma linha por coeficiente da equação (o Intercepto e cada variável independente, com a sua transformação) e as seguintes colunas:
| Coluna | O que significa |
| Coeficiente | Nome do coeficiente, com a transformação da variável. |
| Estimativa | O coeficiente da regressão original — o mesmo exibido nos resultados da regressão linear. |
| EP clássico | Erro padrão do coeficiente pela fórmula tradicional da regressão. |
| EP bootstrap | Erro padrão obtido pela dispersão dos coeficientes nas reamostras. |
| Viés | Diferença entre a média dos coeficientes nas reamostras e a estimativa original. É apenas um diagnóstico (ver seção 5.3). |
| IC95% percentil | Intervalo que contém os 95% centrais dos coeficientes obtidos nas reamostras. |
| IC95% bootstrap-t | Intervalo construído a partir da estatística t de cada reamostra; em amostras pequenas costuma corrigir melhor a assimetria da distribuição do coeficiente. |
Abaixo da tabela, uma nota informa o número de dados, de coeficientes e de reamostras usados. Os coeficientes estão na escala transformada da equação. Se a variável dependente é ln(y), por exemplo, os coeficientes e os intervalos referem-se a ln(y), exatamente como na equação.
5.1 O intervalo contém o zero?
A leitura mais importante é a dos intervalos de confiança:
- o intervalo não contém o zero (os dois limites têm o mesmo sinal): há evidência, ao nível de 5%, de que a variável influencia o valor do imóvel, e o sentido dessa influência (positivo ou negativo) é confiável;
- o intervalo contém o zero (um limite negativo e outro positivo): os dados não permitem afirmar, ao nível de 5%, que a variável tenha influência — nem qual o seu sentido.
Compare essa conclusão com o p-valor clássico do mesmo coeficiente. Quando as duas concordam, o resultado da regressão está bem sustentado. Quando discordam — por exemplo, p-valor clássico de 0,03, mas intervalo bootstrap contendo o zero —, a significância da variável é frágil e merece atenção antes de ser usada como argumento no laudo.
5.2 Comparando os erros padrão
- EP bootstrap parecido com o EP clássico: as suposições da regressão clássica estão funcionando bem para aquele coeficiente.
- EP bootstrap bem maior que o clássico: a incerteza real do coeficiente é maior do que a regressão clássica indica — em geral por resíduos com caudas longas, um dado influente ou heterocedasticidade. Os p-valores clássicos desse coeficiente tendem a ser otimistas.
- EP bootstrap bem menor que o clássico: menos comum; costuma indicar resíduos concentrados com um ou dois valores mais afastados. Verifique os resíduos e os dados influentes.
5.3 O viés é apenas um diagnóstico
O viés mostra se a média dos coeficientes nas reamostras se afasta da estimativa original.
Não corrija a equação subtraindo o viés: com poucos dados, a própria estimativa do viés é muito imprecisa, e a “correção” costuma piorar o resultado. Um viés grande em relação ao EP bootstrap é apenas um sinal de que a distribuição daquele coeficiente é assimétrica — situação em que o intervalo bootstrap-t tende a ser mais adequado que o percentil.
5.4 Percentil ou bootstrap-t?
Os dois intervalos devem ser lidos em conjunto:
- se ambos levam à mesma conclusão (contêm ou não o zero), ela é robusta;
- se o percentil e o bootstrap-t divergem, a distribuição do coeficiente é assimétrica ou instável; prefira a conclusão mais conservadora (a do intervalo que contém o zero) e trate a variável com cautela;
- com muito poucos graus de liberdade (ver seção 7.1), o bootstrap-t pode ficar muito largo — isso é um reflexo honesto da pouca informação disponível, e não um erro do cálculo.
5.5 Exemplo ilustrativo
Os números abaixo são apenas um exemplo de leitura, com uma amostra hipotética de 15 terrenos e a equação ln(Valor) = b0 + b1·ln(Área) + b2·Esquina:
| Coeficiente | Estimativa | EP clássico | EP bootstrap | IC95% percentil | IC95% bootstrap-t |
| ln(Área) | 0,82 | 0,11 | 0,12 | [0,60; 1,05] | [0,57; 1,07] |
| Esquina | 0,15 | 0,06 | 0,09 | [−0,03; 0,32] | [−0,06; 0,35] |
- ln(Área): os erros padrão são praticamente iguais e os dois intervalos ficam longe do zero — a influência da área está bem sustentada.
- Esquina: o EP bootstrap é 50% maior que o clássico e os dois intervalos contêm o zero. Mesmo que o p-valor clássico indique significância, a amostra não sustenta com segurança o efeito de esquina; convém rever os dados (há poucos lotes de esquina? algum deles é atípico?) antes de manter a variável.
6. Levando os resultados para o laudo
Use o botão Copiar e cole a tabela no Excel ou no Word. Ao citar o bootstrap em um laudo, informe o método (Resíduos ou Wild), o número de reamostras e o número de dados — a nota abaixo da tabela já traz essas informações e é copiada junto.
O bootstrap é uma análise complementar. Ele não substitui os resultados da regressão linear e não entra no cálculo do Grau de Fundamentação (NBR 14653-2), que continua baseado nos resultados clássicos da regressão. O seu papel é reforçar — ou colocar em dúvida — a confiabilidade dos coeficientes quando a amostra é pequena.
7. Pontos importantes para dados de imóveis
7.1 Graus de liberdade
O que limita a qualidade da inferência não é só o número de dados, mas a sobra de dados em relação ao número de coeficientes (os graus de liberdade: dados menos coeficientes). Com 12 dados e 5 coeficientes restam apenas 7 graus de liberdade, e qualquer método — clássico ou bootstrap — terá intervalos largos. O bootstrap não cria informação que a amostra não tem: ele
apenas mede a incerteza de forma mais realista.
Continue observando as regras de micronumerosidade da norma: o bootstrap não compensa uma amostra pequena demais para o número de variáveis do modelo.
7.2 O bootstrap herda os problemas do modelo
As reamostras são geradas a partir da equação calculada. Se a equação estiver mal especificada (variável importante ausente, transformação inadequada, dado com erro de digitação), o bootstrap vai medir com precisão a incerteza de um modelo errado. Faça antes as verificações usuais — resíduos, dados influentes, normalidade, heterocedasticidade, linearidade (RESET) — e só então use o bootstrap.
7.3 Variáveis dicotômicas com poucos casos
Uma variável dicotômica (0/1) presente em apenas um ou dois imóveis tem o coeficiente determinado quase só por esses imóveis. O bootstrap tende a mostrar intervalos largos para esse coeficiente — o que é correto: há pouca informação sobre aquele efeito.
7.4 Amostras muito pequenas e o método Wild
No método Wild, cada reamostra é uma combinação de sinais (+ ou −) dos resíduos. Com amostras muito pequenas, o número de combinações diferentes é limitado (com 10 dados, por exemplo, são 1.024), e parte das reamostras se repete. Os resultados continuam válidos, mas aumentar o número de reamostras além desse ponto não acrescenta informação.
Mensagens do sistema
| Mensagem | Causa | O que fazer |
| “O bootstrap dos coeficientes é indicado apenas para amostras pequenas. O modelo possui N dados considerados (máximo: 100).” | O modelo tem mais de 100 dados habilitados. | Para amostras desse tamanho, use a inferência clássica da regressão (teste t). |
| “O número de dados deve ser maior que o número de coeficientes da regressão.” | Não há graus de liberdade para estimar os resíduos. | Reduza o número de variáveis ou aumente a amostra. |
| “As variáveis independentes são linearmente dependentes: os coeficientes não são identificáveis.” | Uma variável é combinação exata de outras (por exemplo, duas variáveis iguais, ou uma dicotômica constante em todos os dados). | Revise as variáveis habilitadas e retire a redundante. |
9. Resumo — fluxo recomendado
- Monte e calcule a regressão linear normalmente e escolha a equação.
- Verifique resíduos, dados influentes, normalidade, heterocedasticidade e linearidade.
- Com até 100 dados, abra Calcular → Bootstrap – Coeficientes.
- Calcule pelo método Resíduos; se houver sinais de heterocedasticidade, calcule também pelo método Wild.
- Para cada coeficiente, verifique se os intervalos contêm o zero e compare o EP bootstrap com o EP clássico.
- Trate com cautela as variáveis cuja significância clássica não é confirmada pelo bootstrap.
- Copie a tabela para o laudo, informando método, número de reamostras e número de dados.