1. Para que serve
O módulo de Random Forest (“floresta aleatória”) do SisDEA é mais uma forma de estimar o valor de mercado de um imóvel a partir de suas características (área, localização, idade, padrão construtivo, etc.), aprendendo o padrão a partir de uma base de imóveis já avaliados — o mesmo objetivo da Regressão Linear e da Rede Neural (RNA) já existentes no sistema, mas com
uma lógica de aprendizado bem diferente por baixo.
Depois de treinado, o modelo guarda o que aprendeu no próprio arquivo “.sda" / ".sdax", junto com o restante do modelo — não é preciso retreinar toda vez que o arquivo é reaberto.
2. Conceitos básicos
2.1 O que é uma árvore de decisão
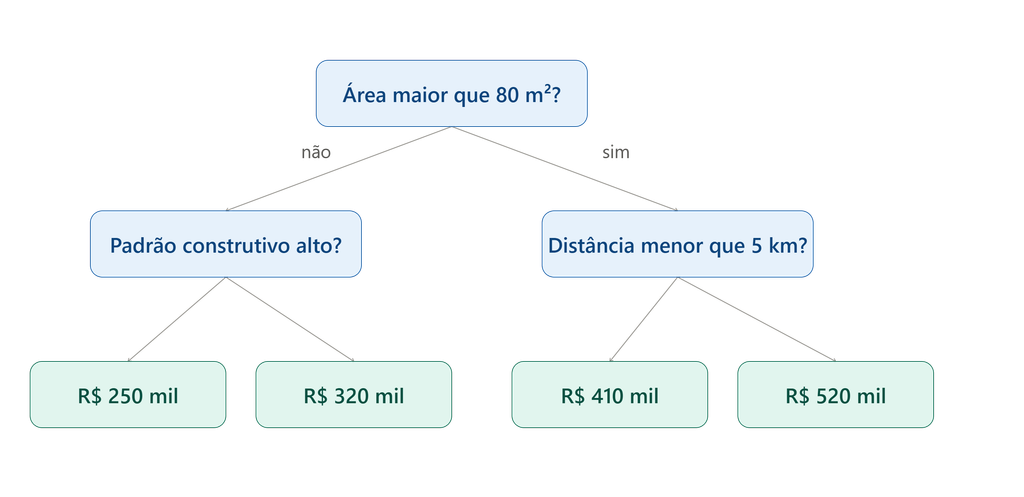
Uma árvore de decisão estima o valor de um imóvel fazendo uma sequência de perguntas do tipo “sim ou não” sobre as suas variáveis — por exemplo: “a área é maior que 80 m²?”, e dependendo da resposta, “a distância ao centro é menor que 5 km?”, e assim por diante. Cada pergunta divide os imóveis da base em dois grupos cada vez mais parecidos entre si, até chegar numa
estimativa de valor para aquele grupo. É um raciocínio parecido com o de um avaliador experiente que vai refinando sua estimativa por eliminação de hipóteses.
Uma única árvore, sozinha, tende a se ajustar demais aos imóveis específicos da base de treino (decorar em vez de aprender o padrão geral) — o mesmo risco de sobreajuste que existe com outros métodos.
2.2 O que é uma “floresta” (e por que ela ajuda)
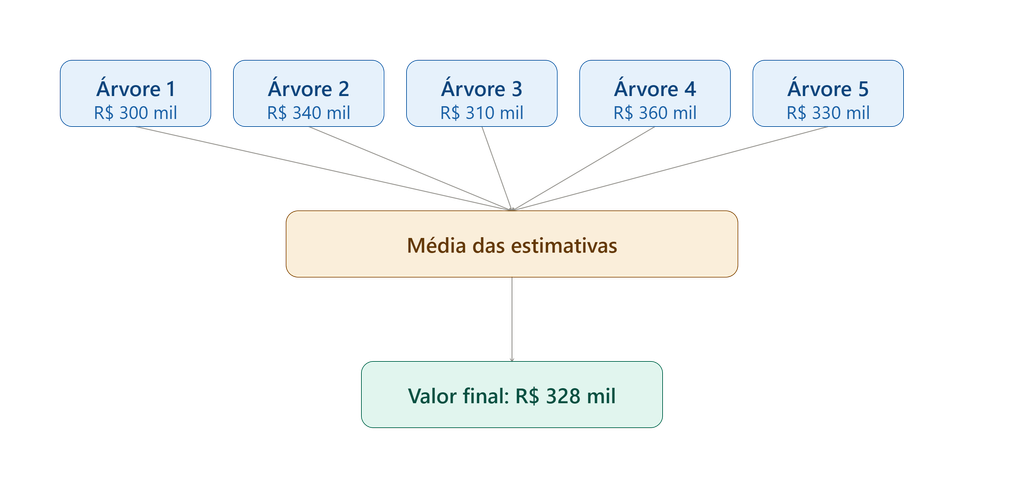
Em vez de treinar uma única árvore, o Random Forest treina centenas delas, cada uma vendo uma amostra ligeiramente diferente da base de dados (sorteada com reposição — a “Amostragem” da seção 3) e considerando, em cada pergunta, apenas um subconjunto sorteado das variáveis disponíveis (as “Variáveis por divisão”). Cada árvore, sozinha, é imprecisa e um pouco
diferente das outras — mas a estimativa final é a média das estimativas de todas as árvores, e essa média costuma ser bem mais estável e confiável do que qualquer árvore individual. É o mesmo princípio de “sabedoria das multidões”: muitas opiniões um pouco erradas, cada uma de um jeito diferente, tendem a se cancelar quando combinadas.
Esse é o motivo de o Random Forest, em geral, ser mais resistente a sobreajuste do que uma única árvore, e por que aumentar o número de árvores raramente piora o resultado — ao contrário de redes neurais, onde treinar por tempo demais pode fazer o modelo decorar os dados (ver seção 4.2).
3. Os campos da tela de treinamento
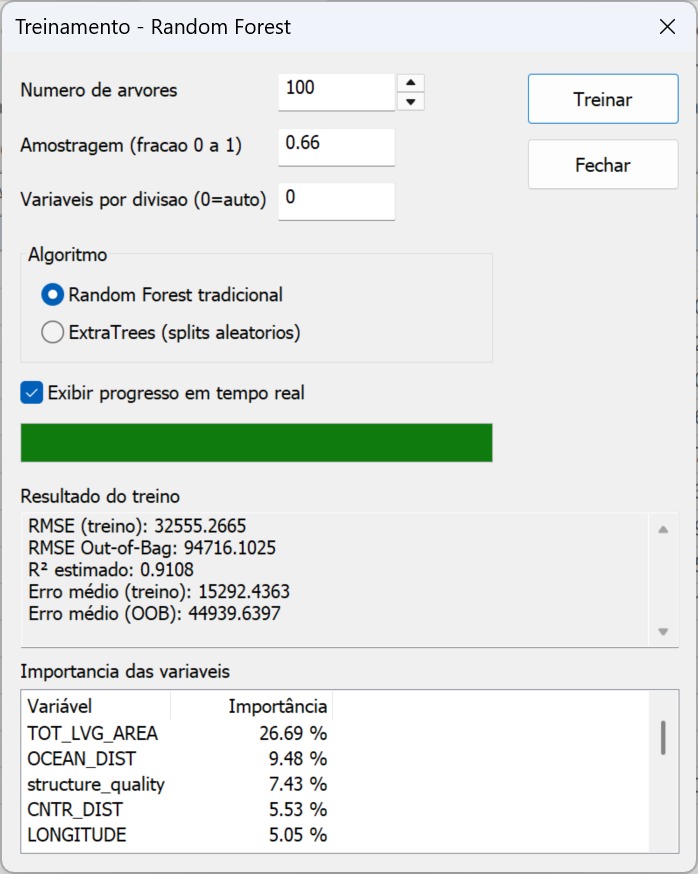
| Campo | O que significa | Padrão |
| Número de árvores | Quantas árvores compõem a floresta. Mais árvores tendem a dar uma estimativa mais estável, ao custo de um treino mais demorado — mas o ganho de qualidade fica pequeno acima de algumas centenas. | 100 (mínimo 10, máximo 5000) |
| Amostragem | Fração da base sorteada (com reposição) para treinar cada árvore individual, de 0 a 1. Valores menores tornam as árvores mais diferentes entre si (mais “diversidade” na floresta); valores muito baixos podem deixar cada árvore com poucos dados para aprender algo útil. | 0,66 (ou seja, ~2/3 da base por árvore) |
| Variáveis por divisão | Quantas variáveis são sorteadas para considerar em cada pergunta da árvore. 0 deixa o próprio sistema escolher automaticamente (recomendado para a maioria dos casos). | 0 (automático) |
| Random Forest tradicional × ExtraTrees | Duas variantes do mesmo método — ver seção 3.1. | Random Forest tradicional |
| Exibir profresso em tempo real | Liga uma barra de progresso durante o treino. Não afeta o resultado final, só o quanto o usuário acompanha o andamento. | Ligado |
3.1 Random Forest tradicional × ExtraTrees
A diferença entre as duas opções está em como cada árvore escolhe o ponto de corte de cada pergunta (por exemplo, o “80 m²” do exemplo da seção 2.1):
- Random Forest tradicional: em cada pergunta, procura o ponto de corte que melhor separa os imóveis (o mais “informativo” possível). É a abordagem clássica e o ponto de partida recomendado.
- ExtraTrees (“Extremely Randomized Trees”): sorteia o ponto de corte de forma aleatória em vez de procurar o melhor. Cada árvore fica um pouco pior individualmente, mas o conjunto todo fica mais diverso — o que, em algumas bases (principalmente com muito ruído ou poucas variáveis realmente relevantes), pode resultar numa floresta final mais robusta, além de treinar mais rápido (não precisa procurar o melhor ponto de corte a cada pergunta).
- Na prática: comece com Random Forest tradicional. Só vale testar o ExtraTrees se o resultado inicial não for satisfatório, ou se o treino estiver demorando demais com uma base grande.
4. Como interpretar os resultados
Depois do treino, a tela mostra um conjunto de métricas — aqui está o que cada uma significa:
- RMSE (treino): o erro médio das estimativas do modelo, medido nos mesmos dados usados para treinar. Sozinho, esse número pode ser enganosamente bom (o modelo “viu” esses dados durante o treino), por isso o número mais importante é o próximo.
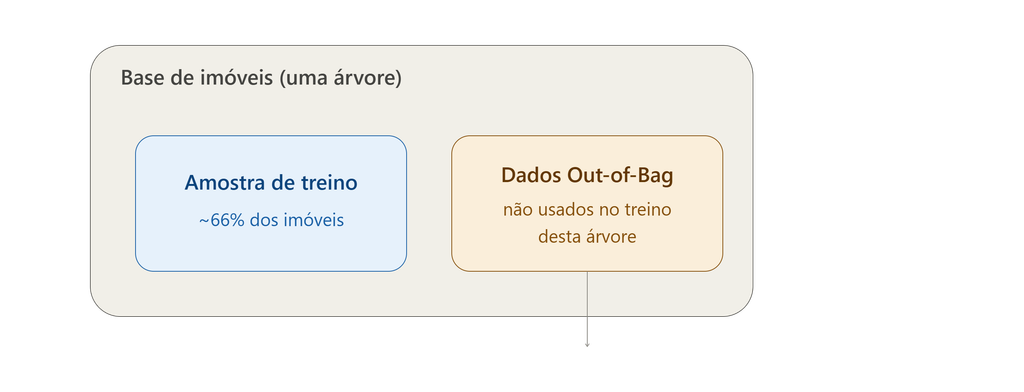
- RMSE Out-of-Bag (OOB): esta é a métrica mais confiável para avaliar a qualidade real do modelo. Como cada árvore só usa uma amostra da base (a “Amostragem” da seção 3), sobra sempre uma parte dos imóveis que aquela árvore específica não viu — os dados”Out-of-Bag” (fora do saco). O sistema aproveita isso automaticamente: cada imóvel é avaliado só pelas árvores que não o usaram no treino, funcionando como um teste “às cegas” embutido, sem precisar separar manualmente uma parte da base para validação (como é recomendado fazer com a RNA — ver seção 4.2 do guia de RNA).
- R² estimado: uma medida de 0 a 1 (às vezes expressa em %) de o quanto o modelo explica a variação dos valores observados — quanto mais perto de 1, melhor. É calculado a partir do RMSE Out-of-Bag, então herda a mesma confiabilidade dele.
- Erro médio (treino) / Erro médio (OOB): parecidos com o RMSE, mas usando outra forma de medir o erro médio — úteis para comparação entre treinos, mas o RMSE OOB continua sendo a referência principal.
Na prática: olhe sempre para os valores “Out-of-Bag”, não para os valores “(treino)” — são os que realmente indicam como o modelo vai se comportar com imóveis que ele ainda não viu.
5. Importância das variáveis
Depois do treino, a tela mostra uma lista das variáveis usadas, ordenada da mais para a menos importante, com um percentual ao lado de cada uma. Esse percentual vem de um teste em que o sistema embaralha os valores de uma variável (só aquela, sorteada aleatoriamente entre os imóveis) e verifica o quanto a qualidade das estimativas do modelo piora com essa “bagunça”. Se embaralhar uma variável não muda quase nada o resultado, ela não estava contribuindo muito; se embaralhar uma variável faz a qualidade despencar, ela é essencial para o modelo. Esse número é uma escala absoluta (não é “a soma de todas dá 100%”) — dá para comparar diretamente com o quanto cada variável, sozinha, contribui para a capacidade preditiva do modelo.
Utilidade prática: além de ajudar a entender o modelo, essa lista é útil para identificar variáveis que poderiam ser removidas da base sem prejuízo relevante à qualidade da estimativa (simplificando a coleta de dados em avaliações futuras), e para confirmar se as variáveis que um avaliador esperaria serem relevantes (área, localização) de fato aparecem no topo da lista — se uma variável esperada aparecer com importância quase nula, vale revisar se ela foi bem coletada/codificada na base.
6. Pontos importantes para dados de imóveis
6.1 Não é preciso normalizar os dados
Ao contrário da Rede Neural (que exige os dados numa faixa fixa — ver seção 4.1 do guia de RNA), o Random Forest não precisa de nenhuma normalização prévia. Como cada “pergunta” da árvore é só uma comparação (“maior que X?”), não importa se uma variável está em metros quadrados e outra em milhares de reais — a escala de cada variável não afeta o aprendizado. Isso simplifica a preparação dos dados e elimina uma fonte comum de erro (esquecer de normalizar, ou normalizar errado).
6.2 Robustez a variáveis atípicas (outliers)
Pelo mesmo motivo da seção 6.1, o Random Forest tende a ser mais resistente a outliers do que a Rede Neural: um imóvel com um valor muito fora do padrão não distorce a escala de comparação das demais variáveis (porque não existe essa escala). Ainda assim, um outlier pode influenciar as árvores que o sortearam na amostragem — revisar a base antes do treino continua sendo uma boa prática, só que menos crítica do que para a RNA.
6.3 Overfitting funciona diferente aqui
Para a RNA, treinar por “tempo demais” (muitas iterações) é um risco real de sobreajuste (seção 4.2 do guia de RNA). Para o Random Forest, aumentar o número de árvores não tem esse mesmo risco — o mecanismo de médias entre árvores (seção 2.2) já protege contra isso.
O principal controle de sobreajuste aqui é a Amostragem: valores muito altos (próximos de 1) fazem as
árvores ficarem parecidas demais entre si, reduzindo o benefício da combinação.
6.4 Variáveis correlacionadas
Bases de imóveis costumam ter variáveis correlacionadas entre si (por exemplo, área construída e número de quartos). O Random Forest lida bem com isso naturalmente — diferente de métodos de regressão tradicionais, onde multicolinearidade é uma preocupação relevante — mas quando duas variáveis são muito correlacionadas, a importância “verdadeira” pode acabar dividida entre elas na lista da seção 5 (cada uma parecendo um pouco menos importante do que seria sozinha).
7. Random Forest × Rede Neural × Regressão Linear — quando usar cada um
| Regressão Linear | Rede Neural (RNA) | Random Forest | |
| Exige normalização dos dados | Não | Sim | Não |
| Sensibilidade a outliers | Alta | Alta | Baixa |
| Captura relações não lineares complexas | Não | Sim | Sim |
| Validação da qualidade do modelo | Estatística clássica (R², testes de hipótese) | Requer separar dados de validação manualmente | Embutida (Out-of-Bag, seção 4) |
| Facilidade de interpretação | Alta (coeficientes diretos) | Baixa | Média (importância de variáveis, seção 5) |
| Tempo de treino típico | Muito rápido | Pode ser lento (depende do método, ver guia de RNA) | Rápido a moderado |
Na prática: não existe um “melhor” método universal — a recomendação é treinar mais de um e comparar o RMSE Out-of-Bag (Random Forest) com o erro de validação da RNA e o R² da Regressão Linear na mesma base. O Random Forest costuma ser uma boa primeira escolha quando a relação entre as variáveis e o valor do imóvel não é claramente linear, mas ainda assim se quer um
processo de treino simples (sem normalização, sem escolher função de transferência) e uma validação de qualidade que não exige separar manualmente uma parte da base.
Situação atual do módulo
O treinamento, a avaliação de qualidade (seção 4) e a importância das variáveis (seção 5) já estão disponíveis em Ferramentas → Treinamento Random Forest…. O modelo treinado fica salvo junto com o restante do arquivo .sda/.sdax. A utilização do modelo treinado para estimar imóveis novos individualmente (a tela de “Projeção”/estimativa, já existente para os outros métodos) ainda não está integrada ao Random Forest — por enquanto, o módulo serve para treinar e avaliar a qualidade do modelo, com a estimativa de imóveis novos prevista como uma próxima etapa.
9. Resumo — fluxo recomendado para uma base de imóveis
- Não é necessário normalizar os dados antes de treinar (seção 6.1) — mas ainda vale revisar a base em busca de erros de digitação/coleta.
- Abra Ferramentas → Treinamento Random Forest… e treine com os valores padrão (100 árvores, amostragem 0,66, variáveis por divisão automáticas, Random Forest tradicional).
- Olhe o RMSE Out-of-Bag e o R² estimado (seção 4) — são a referência confiável de qualidade, sem precisar separar dados de validação à parte.
- Confira a lista de importância das variáveis (seção 5) — confirme se as variáveis esperadas aparecem no topo, e considere simplificar a base se alguma variável aparecer com importância quase nula.
- Se o resultado não for satisfatório, teste aumentar o número de árvores, ajustar a amostragem, ou trocar para ExtraTrees (seção 3.1).
- Compare com os resultados de Regressão Linear e/ou RNA na mesma base (seção 7) antes de decidir qual modelo usar no laudo final.