1. Para que serve
O módulo de XGBoost (“Extreme Gradient Boosting”) do SisDEA é mais uma forma de estimar o valor de mercado de um imóvel a partir de suas características (área, localização, idade, padrão construtivo, etc.), aprendendo o padrão a partir de uma base de imóveis já avaliados — o mesmo objetivo da Regressão Linear, da Rede Neural (RNA) e do Random Forest já existentes no sistema, mas com uma lógica de aprendizado bem diferente por baixo, mais próxima do Random Forest (também baseado em árvores de decisão) do que da RNA ou da Regressão Linear.
Depois de treinado, o modelo guarda o que aprendeu no próprio arquivo ".sda" / “.sdax", junto com o restante do modelo — não é preciso retreinar toda vez que o arquivo é reaberto.
2. Conceitos básicos
2.1 Do Random Forest ao XGBoost: árvores que se corrigem em sequência
Assim como o Random Forest (ver o guia correspondente, seção 2.1), o XGBoost também aprende usando árvores de decisão — sequências de perguntas do tipo “sim ou não” sobre as variáveis do imóvel (“a área é maior que 80 m²?”) que vão dividindo a base em grupos cada vez mais parecidos entre si.
A diferença fundamental está em como as várias árvores se combinam:
- No Random Forest, todas as árvores são treinadas de forma independente e em paralelo, cadauma vendo uma amostra diferente da base, e a estimativa final é a média de todas elas — é a “sabedoria das multidões”.
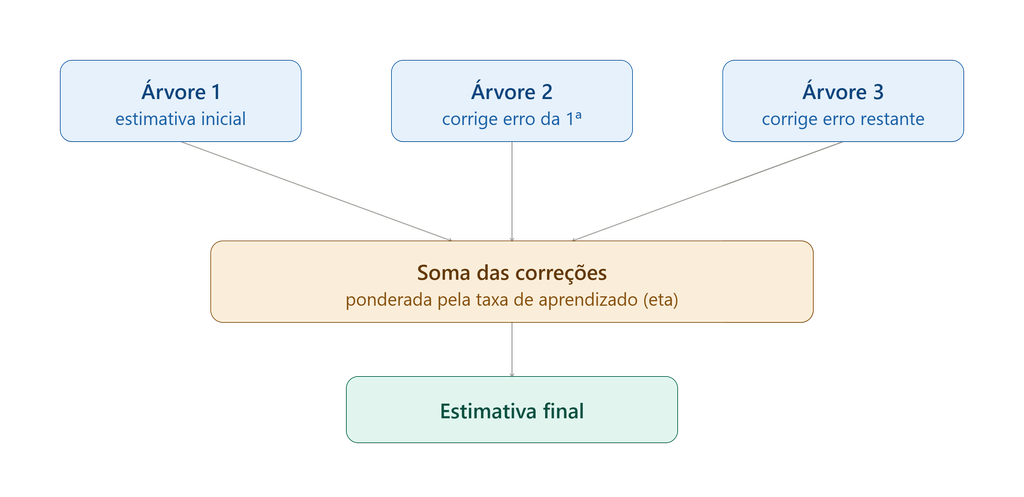
- No XGBoost, as árvores são treinadas uma de cada vez, em sequência: a primeira árvore faz uma estimativa inicial (normalmente ruim); a segunda árvore não tenta prever o valor do imóvel diretamente, e sim corrigir o erro que sobrou da primeira; a terceira corrige o erro que ainda sobrou depois da segunda; e assim por diante. A estimativa final é a soma dessas correções sucessivas, não uma média. Essa técnica se chama “gradient boosting” — cada árvore nova é guiada pelo gradiente do erro das anteriores.
Esse jeito sequencial de aprender costuma capturar padrões mais sutis com menos árvores do que o Random Forest, mas também tem uma consequência importante: como cada árvore nova depende do que já foi aprendido, adicionar árvores demais pode fazer o modelo decorar a base de treino (ver seção 6.3) — diferente do Random Forest, onde isso raramente é um problema.
2.2 O papel da taxa de aprendizado (eta)
Para que a correção de cada árvore nova não “exagere” a mão, o XGBoost pondera a contribuição de cada árvore por um fator chamado taxa de aprendizado, ou eta: em vez de aplicar a correção inteira sugerida por uma árvore, só uma fração dela é somada ao modelo. Taxas de aprendizado baixas tornam o aprendizado mais conservador e estável (mas exigem mais rodadas para chegar num bom resultado); taxas altas aprendem mais rápido por rodada, mas com mais risco de o modelo “exagerar a mão” e sobreajustar a base de treino.
3. Os campos da tela de treinamento
| Campo | O que significa | Padrão |
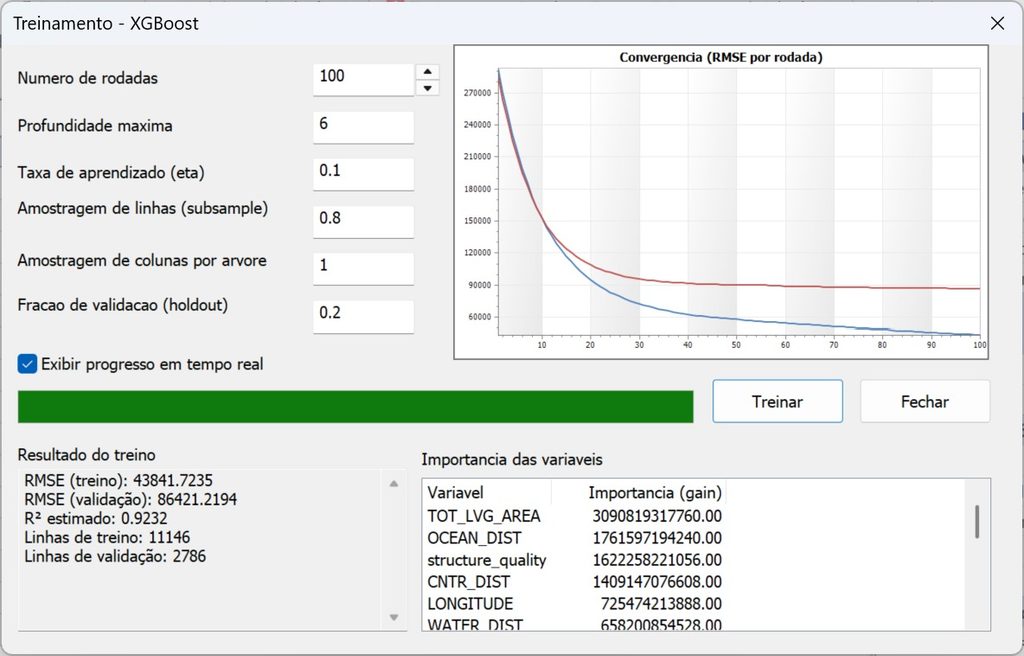
| Número de rodadas | Quantas árvores são adicionadas em sequência, cada uma corrigindo o erro que sobrou das anteriores (seção 2.1). Ao contrário do Random Forest, aumentar demais pode piorar o resultado (ver seção 6.3) — não existe um “quanto mais, melhor” automático aqui. | 100 (mínimo 10, máximo 5000) |
| Profundidade máxima | Quantos níveis de perguntas cada árvore individual pode ter. Árvores mais profundas conseguem capturar relações mais complexas, mas cada uma fica mais propensa a decorar particularidades da base — diferente do Random Forest, aqui isso pesa mais porque as árvores não são simplesmente promediadas, e sim somadas em sequência. | 6 (mínimo 1, máximo 20) |
| Taxa de aprendizado (eta) | Ver seção 2.2. Valores baixos = aprendizado mais conservador (precisa de mais rodadas); valores altos = aprende mais rápido por rodada, com mais risco de sobreajuste. | 0,1 (mínimo 0,001, máximo 1,0) |
| Amostragem (subsample) | Fração das linhas da base sorteadas, a cada rodada, para treinar aquela árvore. Parecido em espírito com a “Amostragem” do Random Forest, mas com outro objetivo: aqui não cria diversidade entre modelos independentes, e sim adiciona aleatoriedade para reduzir o risco de sobreajuste do processo sequencial. | 0,8 |
| Amostragem de colunas por árvore | Fração das variáveis sorteadas para cada árvore nova. Diferente das “Variáveis por divisão” do Random Forest (sorteadas a cada pergunta), aqui o sorteio é feito uma vez por árvore inteira. 1,0 usa todas as variáveis em toda árvore. | 1,0 |
| Fração de validação (holdout) | Fração da base separada antes do treino e nunca usada para ajustar as árvores, reservada só para medir a qualidade do modelo “às cegas” — ver seção 4. Importante: não existe aqui um equivalente automático ao Out-of-Bag do Random Forest; é esse holdout que cumpre esse papel, e não deve ser deixado em zero (ver seção 4). | 0,2 (mínimo 0, máximo 0,5) |
| Exibir progresso em tempo real | Liga uma barra de progresso e o gráfico de convergência (RMSE por rodada) durante o treino. Não afeta o resultado final, só o quanto o usuário acompanha o andamento. | Ligado |
4. Como interpretar os resultados
Depois do treino, a tela mostra um conjunto de métricas e um gráfico de convergência — aqui está o que cada um significa:
- RMSE (treino): o erro médio das estimativas do modelo, medido nas mesmas linhas usadas para treinar. Como no Random Forest e na RNA, esse número sozinho pode ser enganosamente bom (o modelo “viu” esses dados durante o treino).
- RMSE (validação): esta é a métrica confiável para avaliar a qualidade real do modelo — medida sobre a fatia da base separada como holdout (seção 3), que nenhuma árvore usou para ajustar suas divisões. É o equivalente, em espírito, ao RMSE Out-of-Bag do Random Forest, só que aqui obtido separando manualmente uma parte da base, e não automaticamente.
- R² estimado: uma medida de 0 a 1 de o quanto o modelo explica a variação dos valores observados, calculada a partir do RMSE de validação (quando há holdout) — herda a mesma confiabilidade dele.
- Gráfico de convergência: mostra o RMSE de treino (azul) e o RMSE de validação (vermelho) a cada rodada de boosting. É a ferramenta mais útil para diagnosticar sobreajuste (seção 6.3): se a curva de treino continua caindo enquanto a de validação para de cair ou volta a subir, é sinal de que as rodadas depois desse ponto estão só decorando a base de treino, sem melhorar (e às vezes piorando) a capacidade de generalização do modelo.
Atenção: se a Fração de validação for deixada em 0 (sem holdout), o campo “RMSE (validação)” fica zerado e o R² estimado passa a ser calculado a partir do RMSE de treino — um número otimista demais, que não indica como o modelo vai se sair com imóveis que ele não viu. Diferente do Random Forest (que tem o Out-of-Bag embutido mesmo sem configuração extra), no XGBoost é responsabilidade do usuário manter uma fração de validação maior que zero para ter uma avaliação de qualidade confiável — o mesmo cuidado recomendado para a RNA (seção 4.2 do guia de RNA).
O treino também não interrompe sozinho ao detectar sobreajuste (não há “parada antecipada” automática nesta versão): todas as rodadas configuradas são sempre executadas até o fim, e cabe ao usuário olhar o gráfico de convergência e reduzir o Número de rodadas (ou a Taxa de aprendizado) se a curva de validação indicar que o modelo passou do ponto ideal.
5. Importância das variáveis
Depois do treino, a tela mostra uma lista das variáveis usadas, ordenada da mais para a menos importante, com um valor de “gain” ao lado de cada uma.
Esse valor mede, em média, o quanto as divisões que usaram aquela variável, em todas as árvores, ajudaram a reduzir o erro do modelo — quanto maior o “gain” acumulado de uma variável, mais ela contribuiu para as correções feitas ao longo do boosting. É uma escala absoluta e não normalizada (a soma dos valores da lista não é 100%): dá para comparar as variáveis entre si,
mas o valor isolado de uma variável não tem um “teto” fixo de referência. Uma variável que nunca foi usada em nenhuma divisão de nenhuma árvore aparece com importância zero.
Utilidade prática: a mesma da lista de importância do Random Forest (seção 5 do guia correspondente) — ajuda a confirmar se as variáveis que um avaliador esperaria serem relevantes (área, localização) de fato aparecem no topo, e a identificar candidatas à remoção da base semprejuízo relevante à qualidade da estimativa. Como no Random Forest, quando duas variáveis são
muito correlacionadas entre si, o “gain” pode acabar dividido entre as duas (seção 6.4).
6. Pontos importantes para dados de imóveis
6.1 Não é preciso normalizar os dados
Pelo mesmo motivo do Random Forest (seção 6.1 do guia correspondente): como cada “pergunta” da árvore é só uma comparação (“maior que X?”), a escala de cada variável não afeta o aprendizado.
Não é preciso trazer os dados para uma faixa fixa como é exigido pela Rede Neural.
6.2 Mais sensível a outliers do que o Random Forest
Aqui o XGBoost se parece mais com a Rede Neural do que com o Random Forest: como o treino é guiado pelo erro (RMSE) que sobra a cada rodada, um imóvel com valor muito fora do padrão gera um erro grande, e as rodadas seguintes tendem a insistir em corrigir justamente esse erro — mais ainda se a taxa de aprendizado estiver alta.
No Random Forest, por outro lado, um outlier influencia só as árvores que o sortearam na amostragem, e o efeito se dilui na média final.
Na prática: vale revisar a base em busca de erros de digitação/coleta antes de treinar com XGBoost com o mesmo cuidado recomendado para a RNA (seção 4.1 do guia de RNA), mais do que seria necessário para o Random Forest.
6.3 Overfitting é um risco real aqui
Diferente do Random Forest, onde aumentar o número de árvores raramente piora o resultado (seção 6.3 do guia de RF), no XGBoost aumentar demais o Número de rodadas pode, sim, piorar a capacidade do modelo de prever imóveis novos — é o mesmo tipo de risco descrito para a RNA (seção 4.2 do guia de RNA), só que aqui o “tempo de treino” é medido em rodadas de boosting em vez de iterações. Os principais controles de sobreajuste são:
- Número de rodadas e Taxa de aprendizado: reduzir um dos dois (ou os dois) deixa o modelo menos propenso a decorar a base — acompanhe o gráfico de convergência (seção 4).
- Profundidade máxima: árvores mais rasas são individualmente mais simples e generalizam melhor.
- Amostragem e Amostragem de colunas por árvore: valores menores que 1 adicionam aleatoriedade que ajuda a evitar que o modelo se ajuste demais aos mesmos padrões a cada rodada.
6.4 Variáveis correlacionadas
Como o Random Forest, o XGBoost lida bem com variáveis correlacionadas entre si (ex.: área construída e número de quartos) sem o problema de multicolinearidade que afeta métodos de regressão tradicionais — mas, como descrito na seção 5, o “gain” de duas variáveis muito correlacionadas pode acabar dividido entre elas na lista de importância.
7. XGBoost × Random Forest × Rede Neural × Regressão Linear — quando usar cada um
| Regressão Linear | Rede Neural (RNA) | Random Forest | XGBoost | |
| Exige normalização dos dados | Não | Sim | Não | Não |
| Sensibilidade a outliers | Alta | Alta | Baixa | Média/Alta (seção 6.2) |
| Captura relações não lineares complexas | Não | Sim | Sim | Sim |
| Validação da qualidade do modelo | Estatística clássica (R², testes de hipótese) | Requer separar dados de validação manualmente | Embutida (Out-of-Bag) | Requer separar dados de validação manualmente (holdout, seção 3) |
| Risco de sobreajuste ao aumentar o treino | — | Sim (mais iterações) | Praticamente nenhum (mais árvores) | Sim (mais rodadas, seção 6.3) |
| Facilidade de interpretação | Alta (coeficientes diretos) | Baixa | Média (importância de variáveis) | Média (importância de variáveis, seção 5) |
| Tempo de treino típico | Muito rápido | Pode ser lento (depende do método) | Rápido a moderado | Rápido a moderado |
Na prática: não existe um “melhor” método universal — a recomendação é treinar mais de um e comparar o RMSE de validação (XGBoost) com o RMSE Out-of-Bag (Random Forest), o erro de validação da RNA e o R² da Regressão Linear na mesma base. O XGBoost costuma valer a pena testar quando o Random Forest já apresenta um resultado bom, mas se quer tentar espremer um pouco mais de qualidade da mesma base — em troca de precisar prestar mais atenção ao número de rodadas/taxa de aprendizado (seção 6.3) e à qualidade dos dados de entrada (seção 6.2) do que seria necessário com o Random Forest.
Situação atual do módulo
O treinamento, a avaliação de qualidade (seção 4) e a importância das variáveis (seção 5) já estão disponíveis em Ferramentas → Treinamento XGBoost…. O modelo treinado fica salvo junto com o restante do arquivo ".sda" / ".sdax". Internamente, o motor já é capaz de calcular as estimativas do modelo treinado para todos os imóveis da base (e os resíduos correspondentes), e até as contribuições individuais de cada variável para a estimativa de cada imóvel (via SHAP) — mas essas telas específicas (estimativa de um imóvel novo, análise gráfica de resíduos, explicação por imóvel) ainda não estão expostas na interface para o XGBoost. Por enquanto, o módulo serve para treinar e avaliar a qualidade do modelo, com a exposição desses recursos na interface prevista como uma próxima etapa.
9. Resumo — fluxo recomendado para uma base de imóveis
- Não é necessário normalizar os dados antes de treinar (seção 6.1) — mas revise a base em busca de erros de digitação/coleta com atenção redobrada em relação ao Random Forest, já que o XGBoost é mais sensível a outliers (seção 6.2).
- Abra Ferramentas → Treinamento XGBoost… e treine com os valores padrão (100 rodadas, profundidade 6, taxa de aprendizado 0,1, amostragem 0,8, amostragem de colunas 1,0), mantendo a fração de validação acima de zero (padrão 0,2).
- Olhe o RMSE (validação) e o R² estimado (seção 4) — nunca o RMSE (treino) sozinho.
- Observe o gráfico de convergência: se a curva de validação parar de melhorar antes da de treino, reduza o número de rodadas ou a taxa de aprendizado (seção 6.3).
- Confira a lista de importância das variáveis (seção 5) — confirme se as variáveis esperadas aparecem no topo.
- Se o resultado não for satisfatório, ajuste profundidade máxima, taxa de aprendizado, amostragem ou amostragem de colunas (seção 3), sempre reavaliando pelo RMSE de validação.
- Compare com os resultados de Random Forest, Regressão Linear e/ou RNA na mesma base (seção 7) antes de decidir qual modelo usar no laudo final.